
Pustit AI agenta k firemním datům není samo o sobě dobře, ani špatně. Záleží k jakým datům se dostane, co s nimi může dělat, kam je může poslat a hlavně co se stane, když se agent začne chovat jinak, než jsme čekali.

Diskuze o bezpečnosti AI agentů v datech je dost složitá. Každý si totiž pod tím představuje něco jiného.
Někdo to redukuje čistě na legal problém toho, kde se data zpracovávají, jaká je jejich retence a možné GDPR postihy, někdo řeší možný únik dat a pro někoho je to materiální problém - agent rozbije data, způsobí výpadek, nebo desetinásobnou útratu za BigQuery.
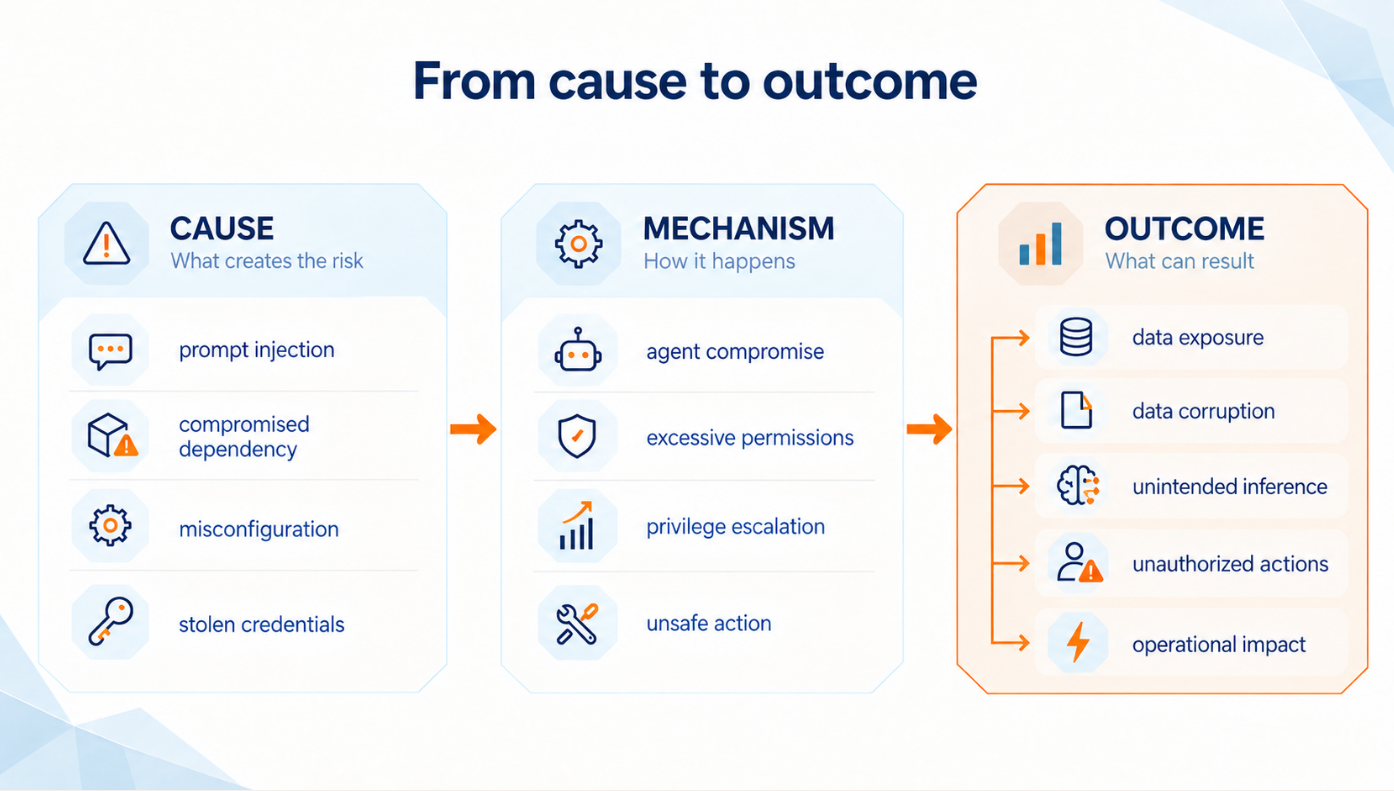
Není jeden jediný správný přístup, který vám vysvětlím a bezpečnost si budete moct odškrnout jako vyřešený problém. Každá firma si to podle mě musí sama vyjasnit. Ta důležitá část je, že to rozhodnutí musí dělat opravdu firma. Ne, že si Franta z nákupu rozhodne, že bez dalšího pustí do firemní databáze Claude Code. Nebo Jiřina, která externě spravuje sociální sítě, nechá analyzovat výsledky kampaní v Codexu. Oba z těchto příkladů použití můžou být v některých firmách úplně v pohodě a v některých ne. Proto to rozhodnutí nemůžou dělat sami.
Nemyslím si ani, že je to rozhodnutí, které by mělo být čistě na security. Protože v tom případě bude přirozeně optimalizovat hlavně na minimalizaci rizika a to je příliš úzké pojetí. Je potřeba, aby si na začátku sedl k jednomu stolu někdo za business, legal, security a ideálně i někdo za data a společně vytyčili hranice. Vedení / business k tomu bude řešit vztah potenciálního rizika a zisku, legal dodá jaké jsou mantinely vycházející ze zákona či smluvních dohod, security se vyjádří k samotné reálnosti a náročnosti a někdo za data je zásadní pro kontext citlivosti a možnosti anonymizace a pseudonymizace.
Obecně je z hlediska bezpečnosti daleko jednodušší řešit zabudované AI agenty. Tak jako máme Vertex AI v GCP Gemini in BigQuery, Microsoft Foundry Agent Service + Fabric data agents, nebo Amazon Bedrock AgentCore. V momentě, kdy ale budete chtít napojovat Claude Code, Codex, nebo lokální modely mimo integrovanou platformu, přidává se další úroveň složitosti.
Agentní mantinely
Nejspíš tušíte, že nastavit system prompt, AGENTS.md, CLAUDE.md apod., kde agenta hezky poprosíte, nebo mu něco důrazně zakážete úplně nestačí (https://www.theguardian.com/technology/2026/apr/29/claude-ai-deletes-firm-database). Pokud nenastavíte opravdu nepřekročitelné technické limity, pracujete čistě s pravděpodobností jestli a kdy se něco pokazí. U externích AI agentů v datech je to o to složitější, protože automaticky naplňujeme všechny tři části lethal trifecta (https://simonwillison.net/2025/Jun/16/the-lethal-trifecta/) - přístup k citlivým datům, vystavení nedůvěryhodnému obsahu a schopnost komunikovat ven.
Což jsou i tři části, které se budeme technicky snažit omezit: co agent uvidí, co bude mít možnost dělat a kam dál bude mít přístup.
A rovnou si ukážeme nejčastější a zároveň nejhorší možný přístup. Spouštíme agenta z terminálu našeho počítače, bez izolovaného sandboxu, k databázi se přihlašujeme přes náš osobní účet, agent má přístup jak k databázi, tak Slack MCP a nemá omezeno, které nástroje může volat a kam všude se může na internetu dostat.
To znamená, že když je agent nějakým způsobem kompromitován, může dělat téměř cokoliv nejen na našem počítači, ale celém širém internetu, upravit libovolnou tabulku a vystavit kamkoli ven naše data.
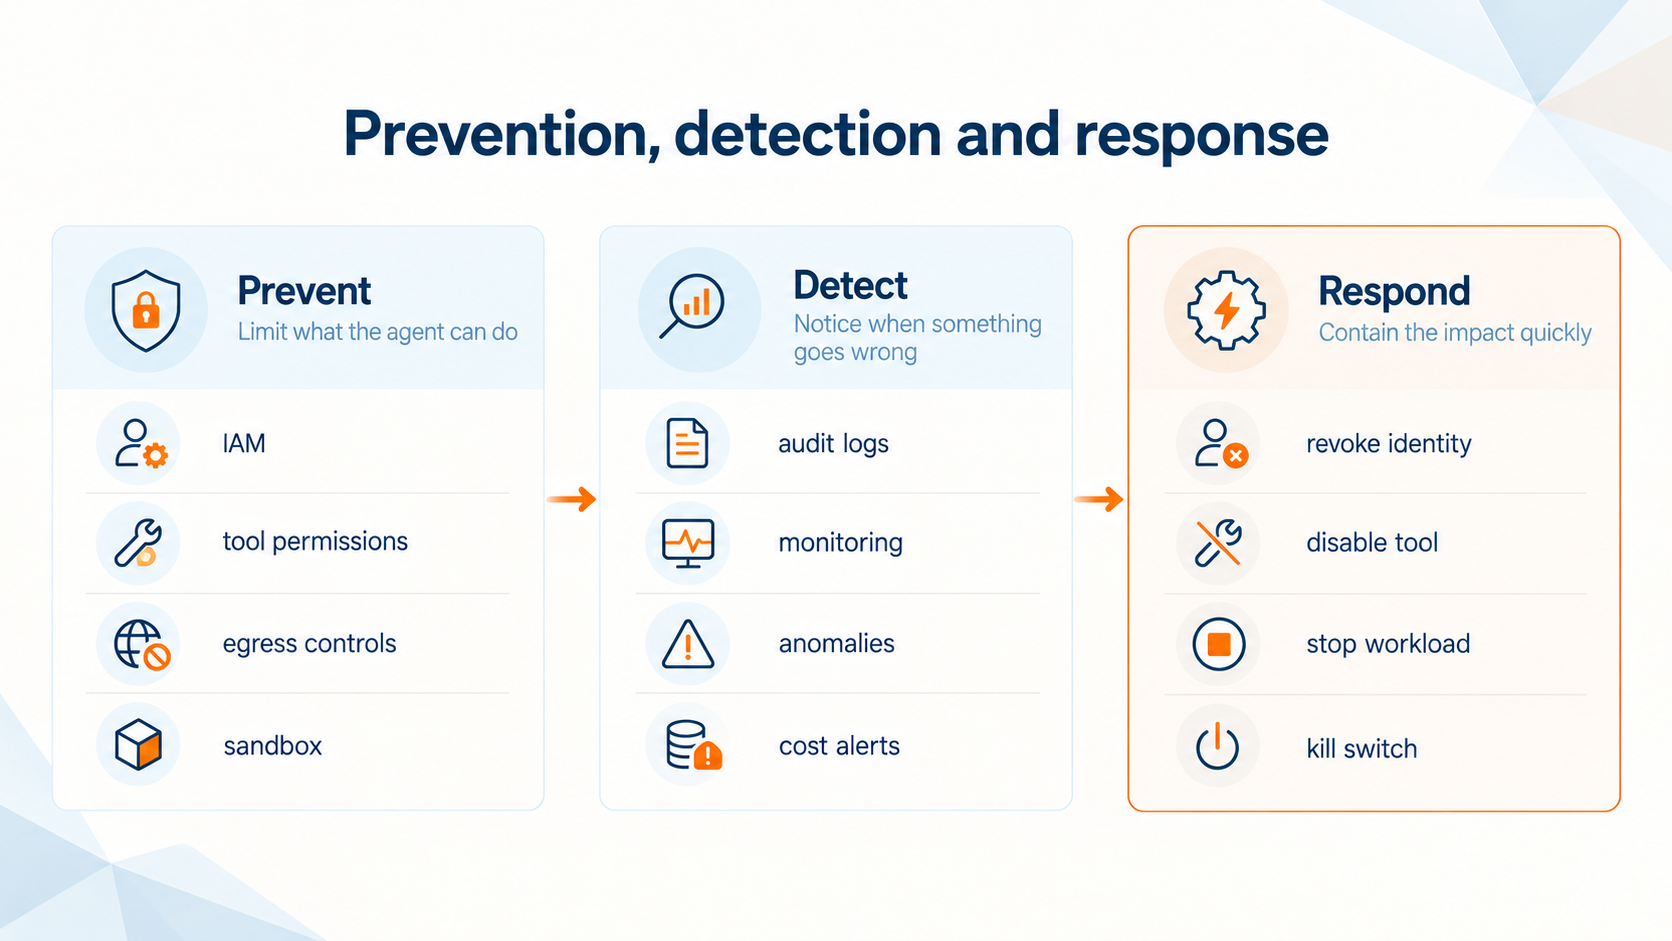
Problém nastane i když agent funguje, tak jak má. Tím, že jsme nenastavili žádné limity na dotazování dat si můžeme škody všimnout až když nám přistane faktura z GCP.
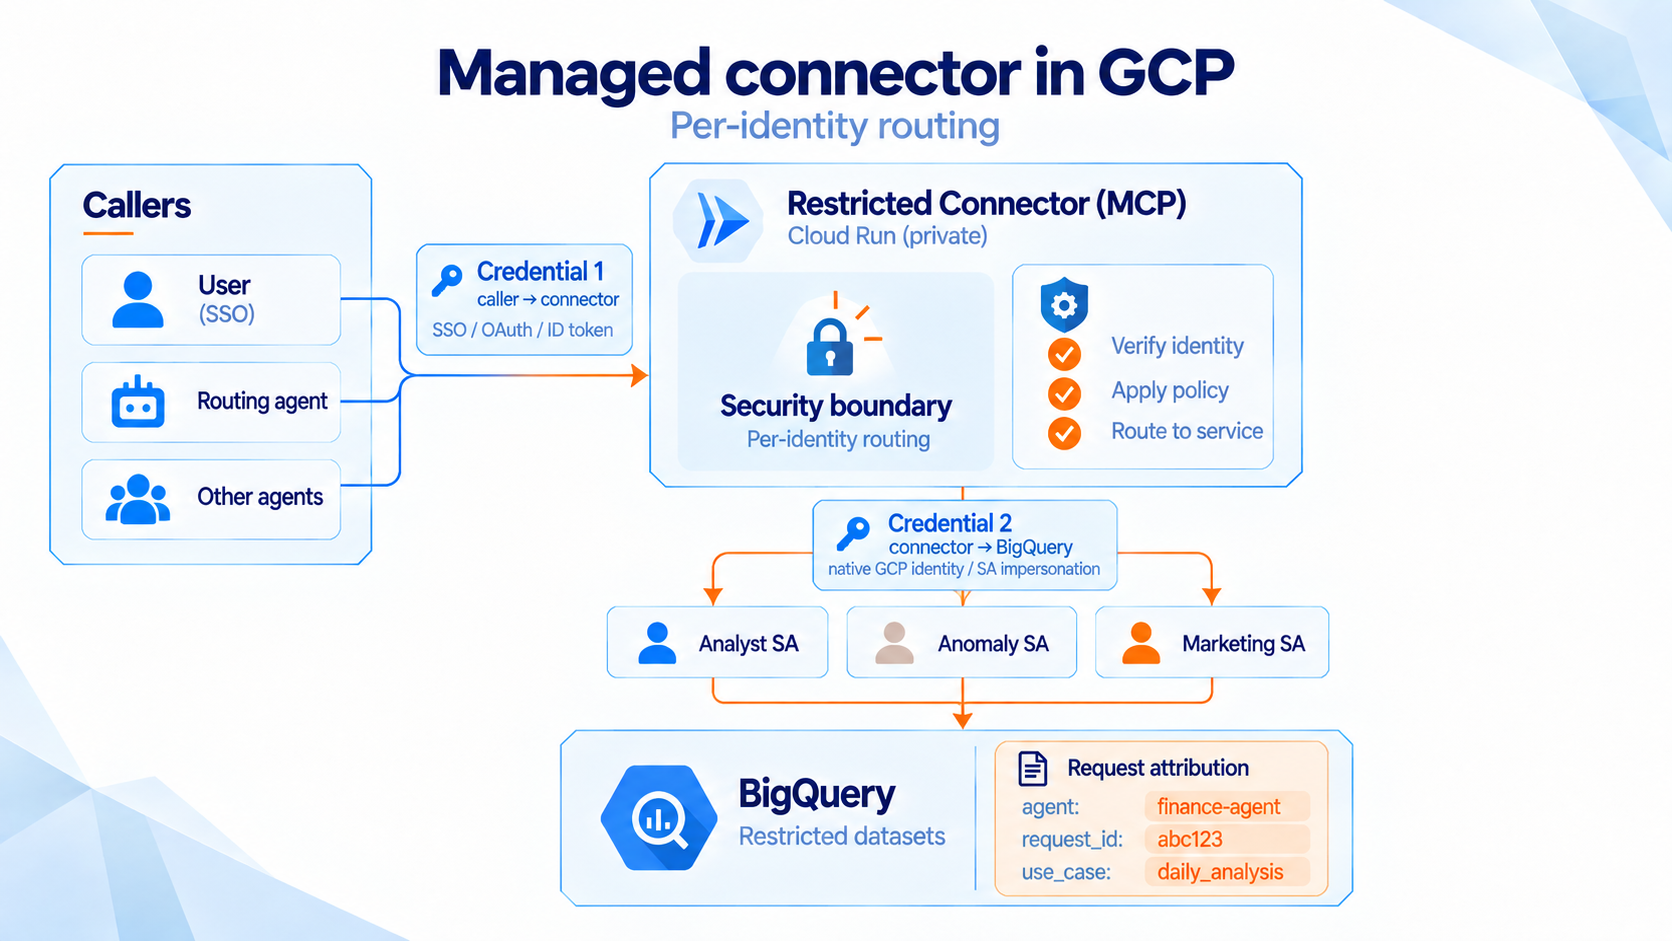
Produkční přístup je o několik řádů složitější. Zvlášť pokud chceme, aby se agent mohl do dat dotazovat nejen, když s ním aktivně pracujeme, ale aby měl zadané pravidelné úlohy, na kterých bude dělat samostatně. Třeba detekovat anomálie, dávat doporučení ke změnám v marketingových kampaních, aktualizovat remarketingové listy, nebo aktualizovat predikční model.
V takovém případě totiž chceme, aby každý z těchto agentů měl přístup k jiné části datasetu. Obecně chceme minimalizovat možnou škodu a dávat tak pro každý účel naprosto nezbytné minimum přístupů a dat. Kromě toho potřebujeme průběžně sledovat, co který agent vlastně dělá a zpětně vyhodnocovat jak je ve své práci úspěšný, jestli se opravdu drží vytvořeného postupu a kolik nás která činnost stojí tokenů a zpracování dat. Pokud každému agentovi nebo tasku už na vstupu nepřiřadíme důvěryhodnou identitu či kontext, budeme je později těžko rozlišovat a jakýkoliv zpětný debugging je peklo.
Systém má tři úrovně mantinelů. Omezení na straně spouštění agenta (dockerizace, uzavřené porty, přístupy pouze k těm nástrojům, ke kterým je nezbytně potřebuje), omezení na straně vlastního MCP (identity-aware routing, vystavení jen úzkých možností použití - například read-only queries s dry-runem) a samotného GCP účtu (přístupy k jednotlivým tabulkám, maskování dat, limity per query a zejména QueryUsagePerUserPerDay).
Když mantinely nestačí
Při návrhu bezpečnostní politiky bychom se neměli spoléhat na to, že budeme všemu schopni předem zabránit. Můžeme něco podcenit, něco nás vůbec nemusí na začátku napadnout a spouštění agentů je přece jen jiná disciplína než spouštění libovolně složitého skriptu. S železnou pravidelností vás bude překvapovat, co se svou vynalézavostí agent vymyslí.
Proto jsem například zmiňoval ten QueryUsagePerUserPerDay - kumulativní omezení per agent. Pokud totiž agentovi omezíme pouze velikost jednotlivého dotazu a on bude vědět, že mu to na splnění úkolu nestačí, tak ten dotaz s drobnými změnami zavolá vícekrát. Třeba 2000x. Ano, i to už jsme viděli.
Potřebujeme způsob, jak sledovat, co agent dělá, na co se v datech doptává, co se v GCP děje a mít možnost ať již manuálně, nebo automaticky zareagovat. V některých případech budeme schopni agenta zastavit už v momentě, kdy bude chtít dělat něco, co nemá (odmítnout konkrétní tool call), v některých to kvůli omezením jsme schopni řešit až v průběhu (zrušit běžící BigQuery job), nebo ex post. I tak můžeme díky revokaci přístupů, nebo jinému kill switch mechanismu škodu minimalizovat.
I v této části platí, že při využívání zabudovaných AI agentů je často celá / většina této infrastruktury už vybudovaná a ušetříte si dost práce.
Takže pokud vám stačí, že je agent zavřený ve vašem datovém skladu a nechcete využít dotovaný subscription model, je to nejjednodušší možnost. Pro jistotu, to neznamená, že si nemusíte při použití zabudovaných agentů tím cvičením ze začátku projít. Zabudovaný agent nerovná se bezpečné použití agenta v datech. Ale v momentě, kdy si ty hranice v rámci firmy nastavíte, se zabudovanými agenty se jich můžete jednodušeji držet.
Jakmile ale chcete, aby jeden agent pracoval napříč BigQuery, reklamními platformami, Slackem nebo interními API, přestává vám samotná bezpečnostní vrstva datového skladu stačit. A buď stejně budete muset tuto část řešit i u zabudovaného agenta, kterému budete dávat přístup ven, nebo budete celkovou integraci řešit přes externího agenta. Celkově mi přijde, že pracovat se spoustou uzavřených agentů v rámci velmi malého výseku, dost limituje, co vůbec s AI agenty můžeme dělat a je to slepá vývojová cesta.
Co dál
O monitoringu AI agentů v datech jsem přednášel na AI bootcampu a na londýnském MeasureCampu. Můžete si prohlédnout prezentaci (https://docs.google.com/presentation/d/1orAIhsobYNVPDQELdMiyGRXFcnLxcp3S6_fdl6qJPlA/edit?usp=sharing) i když se bojím, že samotné slidy vám toho tolik neřeknou.
A pokud vás otázka bezpečnosti a AI agentů v datech zajímá víc do hloubky, můžete si koupit záznam z našeho online školení.